Comparatif · Guide pratique
n8n ou Make : lequel choisir pour une automatisation avec de l'IA ?
Comparer les outils sur un même flux et ses coûts complets.
Choisissez n8n ou Make en testant le flux que votre équipe devra exploiter : connexions, droits, validation humaine, reprise après erreur et coût à votre volume. Pour un service hébergé, comparez Make et n8n Cloud sur le même parcours. Si vous devez héberger l'orchestration dans votre environnement, examinez n8n avec la personne qui assurera mises à jour, sauvegardes et reprise.
Vos opérations obligatoires, volumes et contraintes de données.
Télécharger le kit de cet articleCe comparatif repose sur les fonctions et modes de facturation documentés par les éditeurs, consultés le 3 octobre 2026. Aucun essai comparatif exécuté sur les deux plateformes n'est revendiqué. La grille fournie prépare cet essai sans attribuer de notes fictives aux outils.
Pour travailler sur votre propre projet : ouvrez le dossier PDF de 6 pages, puis le tableur modifiable. Vous y trouverez un cas rempli, une décision conditionnelle, un budget qui se recalcule et sept essais à faire exécuter. Le kit complet réunit ces fichiers et les grilles techniques. Les données du cas sont fictives ; les résultats des plateformes restent « non testé ».
Qu'est-ce qui change réellement entre les deux ?
Les deux outils permettent d'organiser des étapes entre applications. La présence d'un module IA ne résout pas à elle seule les questions d'accès, d'identité ou de validation. Le choix concerne aussi l'endroit où le flux s'exécute, sa facturation et la personne qui s'en occupe lorsqu'il échoue.
| Critère | n8n | Make | Vérification utile |
|---|---|---|---|
| Exploitation | Offres Cloud et possibilités d'auto-hébergement | Plateforme hébergée | Qui administre le service et traite les incidents ? |
| Facturation du service | Offres présentées notamment par exécutions | Crédits consommés selon les opérations et fonctions | Relever la consommation du même parcours |
| Connexions métier | Nœuds et interfaces selon les services | Modules et interfaces selon les services | Vérifier l'action exacte et les droits requis |
| Erreurs | Comportement à configurer pour le flux | Gestionnaires d'erreurs documentés | Tester une erreur avant et après l'écriture |
| IA | Modèle et connexion à sélectionner | Mode de connexion influant sur la consommation | Identifier où partent les données et qui facture |
Les offres n8n et la documentation des crédits Make utilisent des unités différentes. Mille exécutions ne sont donc pas directement comparables à mille crédits. Une exécution peut traverser plusieurs étapes ; la consommation d'un module IA peut aussi dépendre de son mode de connexion.
La page n8n distingue aussi les crédits de son Assistant, utilisé pour construire les workflows. Relevez séparément ces crédits, les exécutions du flux et la consommation du modèle appelé : ce sont des postes différents.
L'auto-hébergement de l'orchestrateur ne signifie pas que tout reste local. Si une étape appelle un modèle externe, examinez ce transfert séparément. Notre guide IA privée ou publique aide à poser les questions d'architecture.
Comment éliminer une option avant de comparer son prix ?
Vérifiez d'abord l'action exacte du connecteur avec vos droits, puis les destinations de données et la reprise. Un connecteur présent dans un catalogue ne démontre pas qu'il prend en charge le champ, le volume ou le mécanisme de validation attendu.
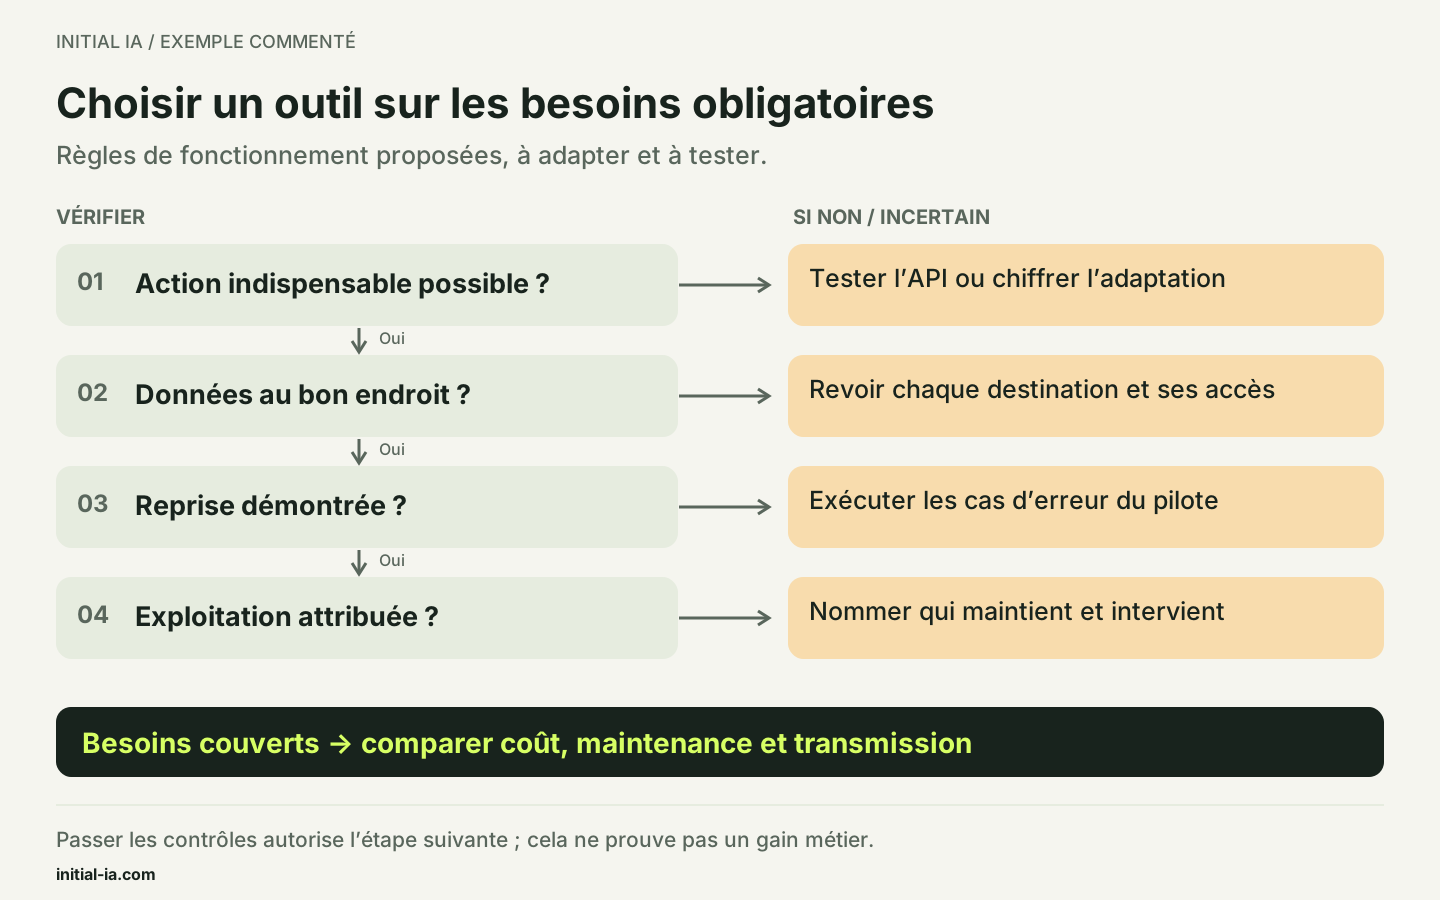
Lorsqu'un point manque, chiffrez l'adaptation au lieu de lui attribuer une note arbitraire. Un appel API supplémentaire, une validation externe ou une revue manuelle peuvent être acceptables si leur coût et leur responsable sont connus. Une écriture sans accord, un accès interdit ou une reprise qui crée un doublon doit bloquer le pilote jusqu'à correction. Une bonne note sur le prix ne compense pas l'échec d'une exigence obligatoire.
Quel petit flux utiliser pour comparer ?
Dans le cas rempli du PDF, une entreprise de maintenance reçoit DEM-104 : « notre poste d’accueil ne démarre plus, pouvez-vous intervenir mardi matin à Rouen Centre ? ». Le contact C-042 est unique dans le jeu de test, sa fiche est en version 7. Le résultat attendu est un brouillon d’intervention lié à DEM-104, après approbation de la proposition p1. Le créneau demandé reste du texte : ni date confirmée, ni prix, ni diagnostic ne sont inventés. Si la fiche change avant l’écriture, l’accord doit être renouvelé. Aucun message client n’est envoyé par ce pilote fictif.
L’équipe fictive connaît déjà Make et accepte un service hébergé : elle commence donc par un pilote Make, sous réserve des sept essais. Une équipe déjà équipée de n8n commencerait par son environnement actuel ; sans outil existant, comparez Make et n8n Cloud. Une contrainte d’hébergement de l’orchestration chez vous conduit à examiner n8n auto-hébergé avec un exploitant nommé. Ce sont des critères d’ordre d’essai, pas un classement de performance.
Prenez une demande client fictive : réception, lecture du besoin, recherche d'un contact, préparation d'une action, validation et écriture dans un environnement de test. Faites passer les mêmes entrées et imposez les mêmes résultats attendus sur les deux outils.
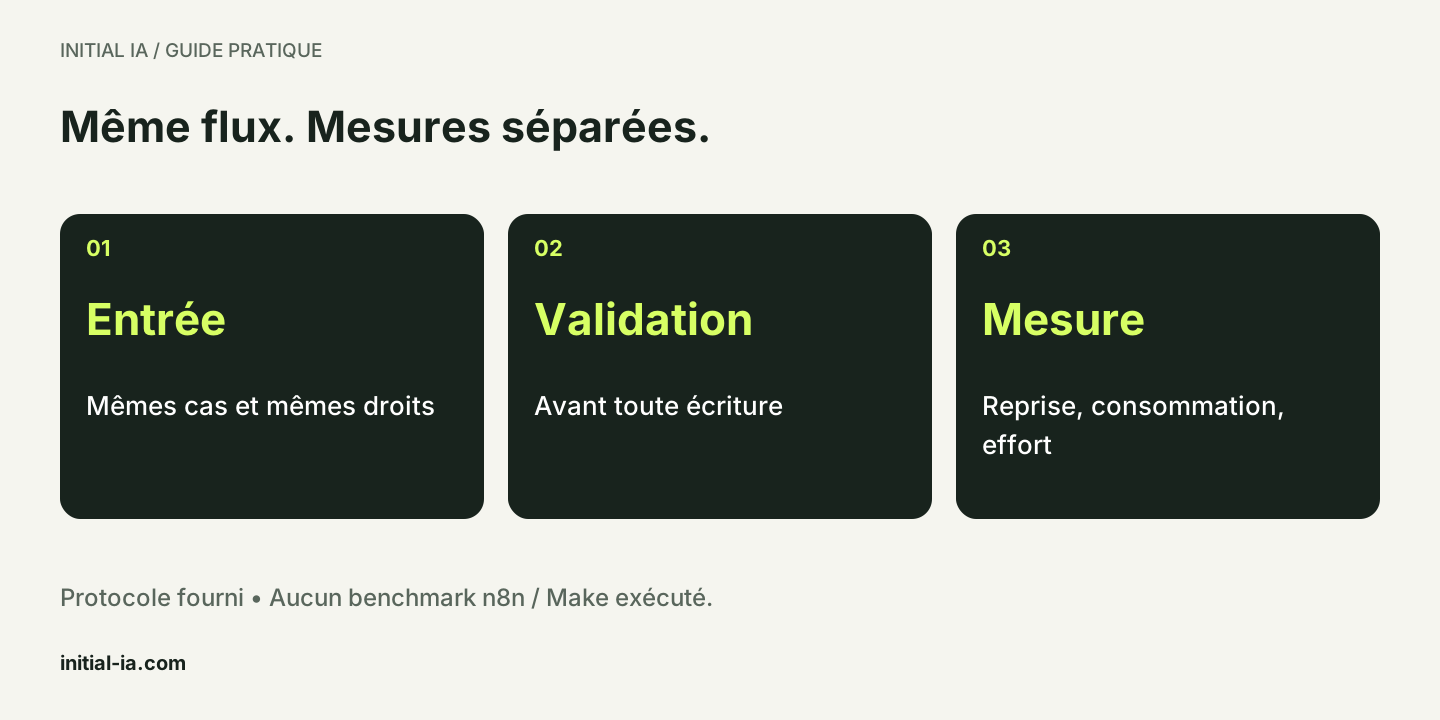
La recette à exécuter prévoit une entrée valide, une identité ambiguë, une API indisponible, une répétition du même événement et une modification de fiche pendant la validation. Les deux tests de reprise et d'approbation complètent cette recette. Les résultats restent vides tant que le test n'a pas été exécuté : un résultat attendu n'est pas une preuve de réussite.
Que faut-il tester quand une étape échoue ?
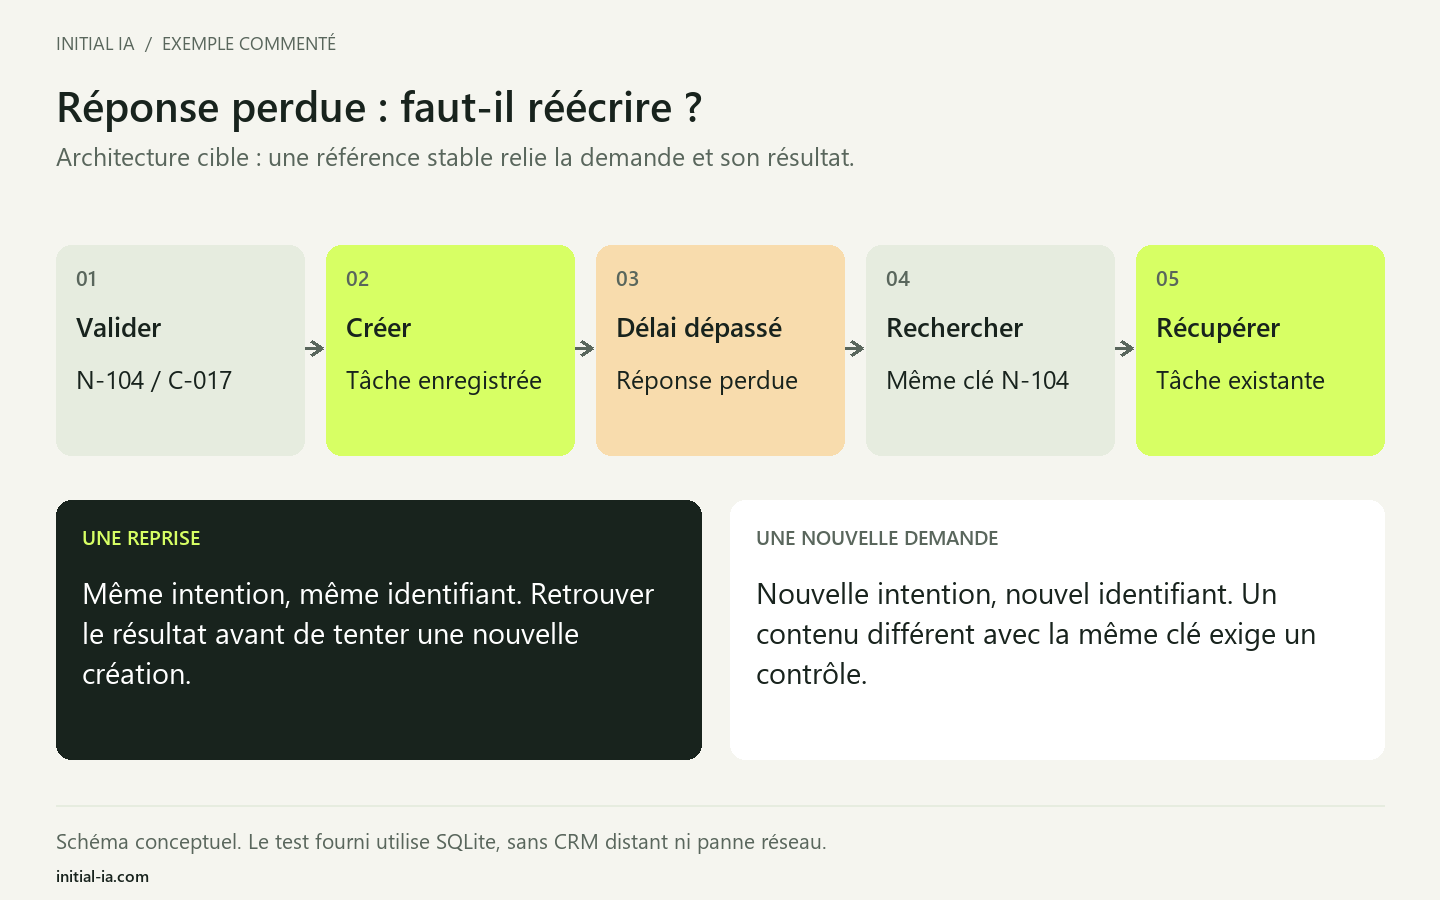
Supposons que la demande fictive DEM-104 soit approuvée. Le CRM crée une fiche, mais sa réponse se perd. L'automatisation voit un délai dépassé ; cela ne dit pas si la création a eu lieu. Relancer l'étape telle quelle peut créer une seconde fiche.
Avant la première écriture, prévoyez une référence stable reliée à la demande. Lors de la reprise, recherchez cette référence dans la destination : si la fiche existe et correspond à l'action approuvée, consignez-la et poursuivez sans recréer. Si l'état reste incertain ou si cette recherche n'est pas possible, mettez la demande en revue. Un simple « chercher puis créer » ne suffit pas contre deux reprises simultanées : il faut aussi un mécanisme empêchant les doublons côté destination, ou une reprise supervisée qui évite ces écritures concurrentes.
| Test complémentaire | Résultat attendu dans ce pilote | Preuve à conserver |
|---|---|---|
| Réponse perdue après création | La reprise retrouve la même fiche ; aucune seconde création | Référence de demande, identifiant de fiche et traces avant/après |
| Approbation absente ou portant sur une ancienne version | Aucune écriture ; demande visible dans la file de revue | Version proposée, état de validation et état de la destination |
Make documente plusieurs gestionnaires d'erreurs, mais leur nom ne décrit pas tous leurs effets. Son Rollback concerne les modules compatibles avec les transactions et dépend du réglage d'auto-commit ; il n'annule pas toute action externe, comme un email déjà envoyé. Vérifiez donc l'opération réelle, ses réglages et l'état de l'application cible.
Le démonstrateur SQLite du guide CRM illustre la reconnaissance d'une écriture déjà réalisée. Il est indépendant de n8n et Make. Les deux cas ci-dessus sont un protocole à exécuter sur vos connexions, pas des résultats obtenus sur ces plateformes.
Que faut-il compter dans un flux avec plusieurs branches ?
Distinguez demandes métier, appels au modèle, validations humaines et tentatives d'écriture. Ces quantités décrivent votre fonctionnement ; elles ne se convertissent pas directement en crédits Make ou en exécutions facturées n8n.
Notre scénario de dimensionnement fictif reçoit 1 000 demandes. Chacune utilise un appel de modèle et 200 nécessitent une revue approfondie, selon la règle choisie pour l'exercice. Toutes restent soumises à la validation prévue avant écriture. Sur 1 000 premières tentatives d'écriture, 50 échouent avant toute création puis sont reprises une fois : 1 050 tentatives au total. Si la sortie du modèle a été conservée et reste valide, ces reprises n'exigent pas un nouveau raisonnement IA.
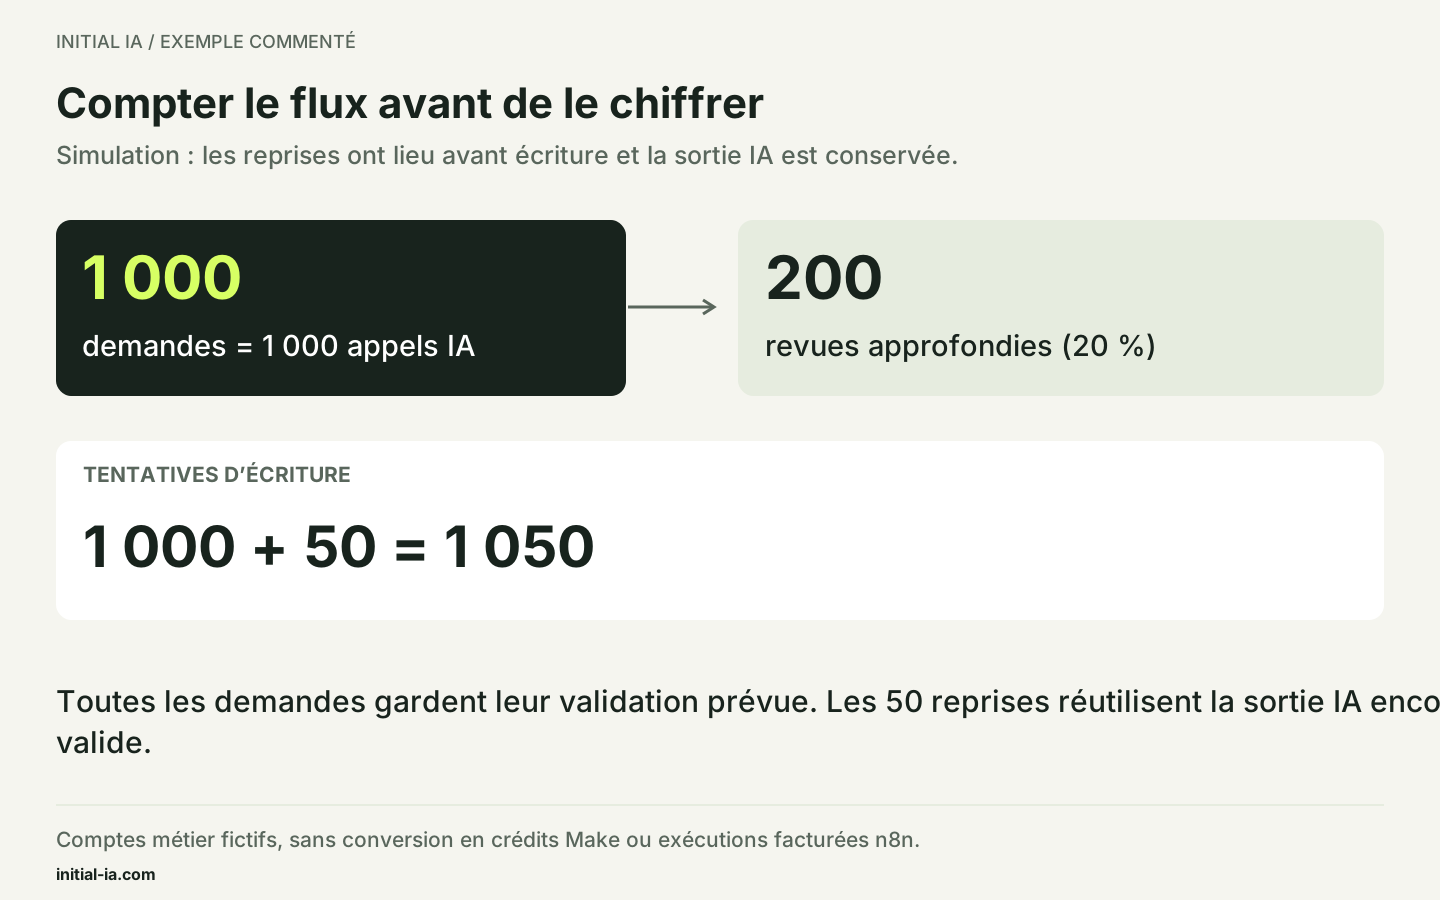
Le tableau de dimensionnement rend les hypothèses explicites. Il ne mesure pas un fonctionnement de n8n ou Make. Une panne à un autre endroit, une sortie devenue périmée ou une stratégie de reprise différente peut changer les comptes.
Comment comparer les coûts sans se tromper d'unité ?
Notez le nombre d'entrées, les branches réellement parcourues, les appels de modèle et les reprises. Utilisez ensuite le plan commercial applicable, sa devise, sa période d'engagement et ses dépassements éventuels. Les tarifs et fonctions doivent être revérifiés au moment du choix sur les pages Make et n8n.
Votre budget comprend aussi la conception, l'hébergement lorsqu'il vous revient, la maintenance et la relecture humaine. Pour l'IA, vérifiez si la consommation du modèle est comprise dans les crédits ou facturée par un fournisseur distinct. Ne comptez pas deux fois le même poste, mais ne l'oubliez pas non plus.
La formule de travail est simple : coût de mise en place réparti sur la période + abonnement + consommation variable + exploitation + validation humaine. Le journal de mesure prévoit une ligne par parcours et par outil : demande, exécution, résultat, unités facturées, temps humain et preuve. Reportez le compteur réellement observé et le plan daté ; ne déduisez pas les crédits du seul nombre de blocs à l'écran. Séparez les demandes terminées, refusées et encore en attente pour qu'un flux qui abandonne des dossiers ne paraisse pas artificiellement moins cher.
Exemple chiffré : combien coûte le temps de relecture ?
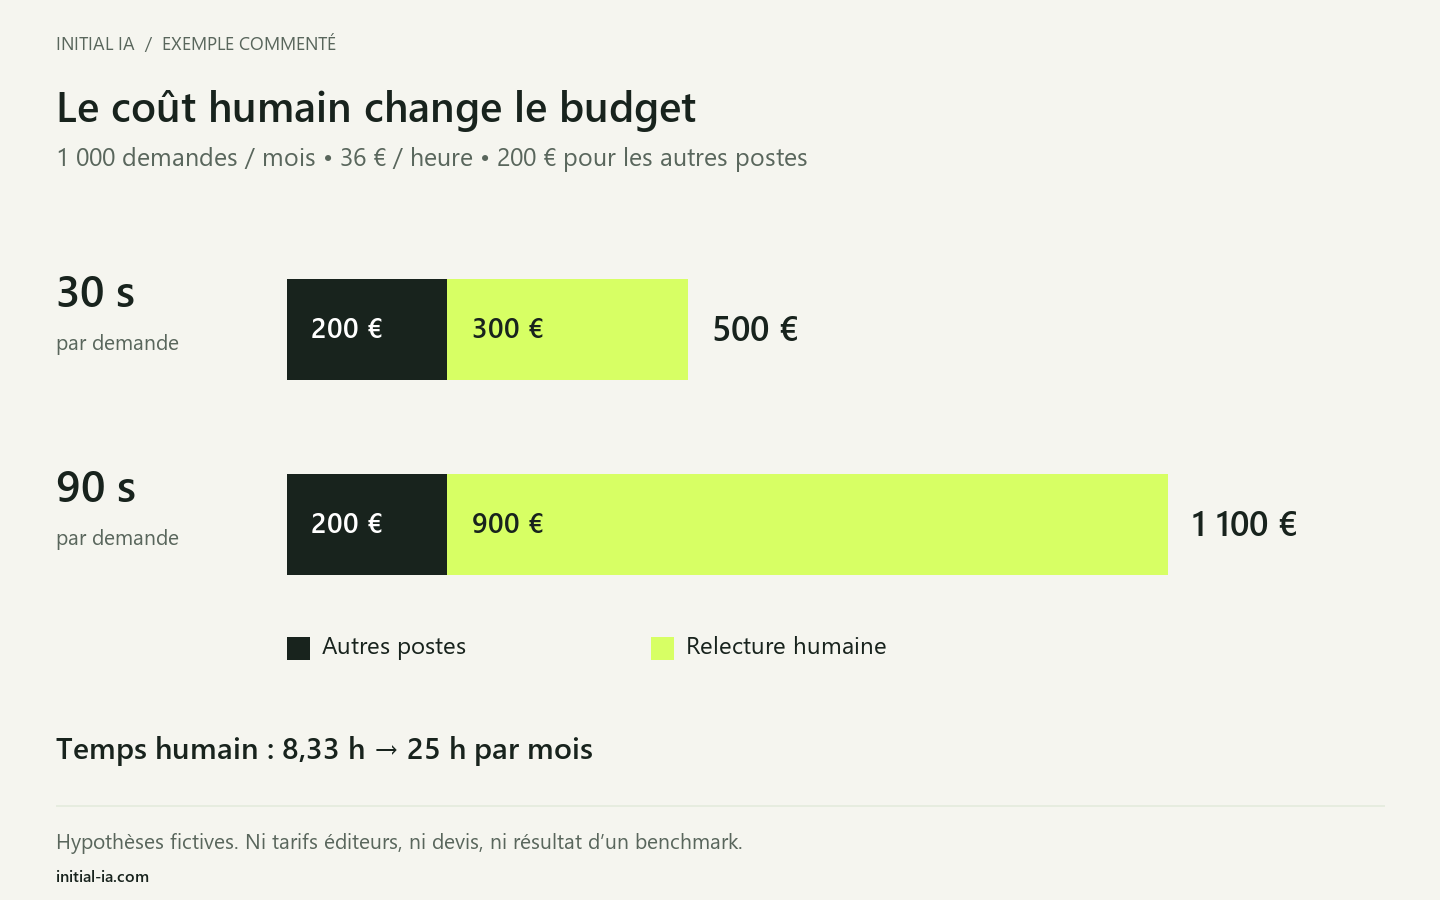
Prenons un budget fictif, sans lien avec les prix de n8n ou Make. Hypothèses : 1 000 demandes par mois, 30 secondes de relecture par demande, un coût interne de 36 €/heure et 200 € par mois pour les autres postes. Ces 200 € regroupent ici mise en place répartie, service, consommation et exploitation afin d'isoler l'effet de la relecture.
Le temps humain représente 1 000 × 30 / 3 600 = 8,33 heures, soit 300 €. Le budget mensuel de travail est donc de 500 €. Si la relecture prend 90 secondes, elle représente 25 heures et 900 € : le total atteint 1 100 €, en gardant les autres hypothèses identiques.
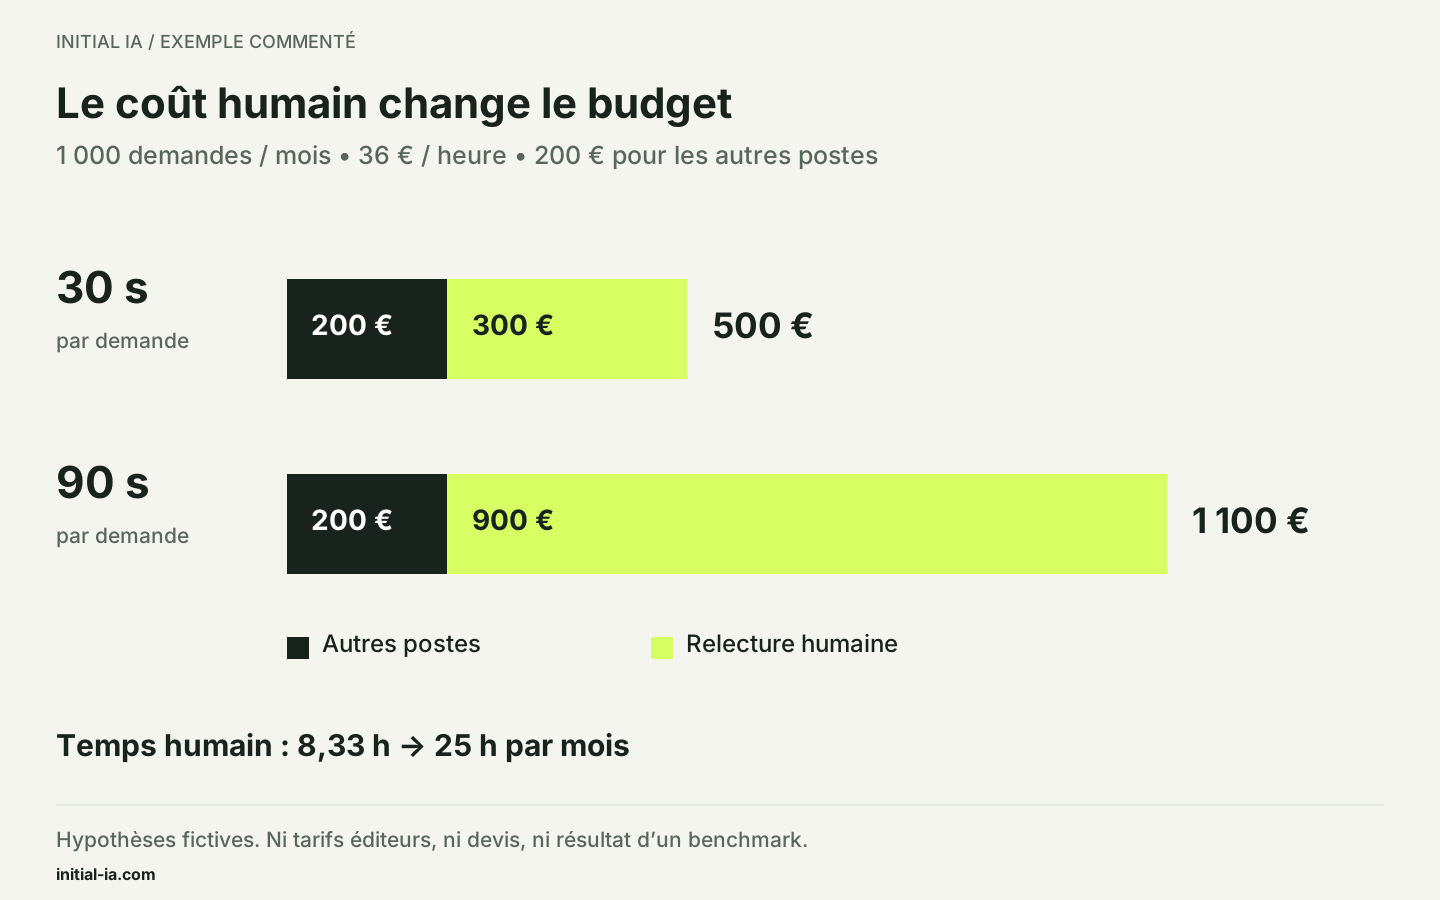
Le fichier de calcul des hypothèses détaille ces deux scénarios. Les montants ne constituent ni un devis Initial IA ni une estimation tarifaire des éditeurs. Dans votre budget, séparez ensuite les postes regroupés et vérifiez si certains augmentent avec le volume. Une capacité humaine libérée n'est pas automatiquement une économie de trésorerie.
Comment prendre la décision après le pilote ?
Commencez par les exigences obligatoires. Un cas non exécuté reste « non vérifié » ; une erreur de droits, de validation ou de doublon impose une correction suivie d'un nouvel essai. Cette règle proposée doit être convenue avec le responsable métier avant le pilote.
Pour les solutions qui passent ces contrôles, comparez le même périmètre terminé : temps de validation et de reprise, coût des services, entretien des connexions et responsable disponible. Conservez les résultats par cas en plus du total. Quelques dossiers longs à corriger peuvent disparaître derrière une moyenne rassurante.
Un abonnement moins cher peut coûter davantage à exploiter. Exemple fictif indépendant des deux éditeurs : 60 € de service économisés chaque mois, mais deux heures supplémentaires de maintenance à 60 €/heure, donnent 120 € de travail en plus et un coût total supérieur de 60 €. Ce calcul compare des hypothèses ; il ne prédit pas le coût de votre installation.
Que transmettre pour que le choix reste exploitable ?
Faites reprendre un cas en erreur par une autre personne, avec la documentation seule. Elle doit pouvoir retrouver la demande, savoir ce qui a déjà été écrit et identifier l'action autorisée. Si elle doit demander à l'auteur du flux à chaque étape, la transmission n'est pas terminée.
La fiche de décision rassemble le périmètre testé, les résultats, les coûts, les réserves, le responsable et son relais. Elle prévoit trois issues : poursuivre sur ce périmètre, corriger puis retester, ou écarter l'option. Notez aussi quand rouvrir le choix : changement de volume, de connexion, de modèle ou de droits qui affecte le résultat. Une autre équipe pourra comprendre la décision sans refaire toute l'enquête.
À vous de décider : peut-on convertir les tentatives en crédits ?
Cas fictif : votre scénario prévoit 1 000 demandes et 50 reprises après échec avant écriture. Une personne propose d'inscrire automatiquement 1 050 crédits Make et 1 050 exécutions n8n au budget. Est-ce justifié ?
- A. Non : ce sont des tentatives métier ; il faut mesurer les unités facturées du parcours réel.
- B. Oui : une tentative correspond toujours à une unité facturée.
- C. Oui, à condition que le modèle IA soit le même.
Voir la correction commentée
A. Les 1 050 tentatives décrivent l'hypothèse de fonctionnement, pas une unité commerciale commune. Relevez le parcours, les branches, les appels et la consommation observée selon l'offre applicable. Le calculateur de relecture complète ensuite le budget avec le temps humain ; ses montants fictifs ne sont pas les prix des éditeurs.
À adapter : quels postes sont compris dans votre abonnement et lesquels doivent être mesurés séparément ?
Essayer vos hypothèses dans le calculateur. Les calculs restent sur votre appareil ; aucune donnée n’est envoyée.
Faut-il de l'IA dans le flux ? Pas pour recopier un champ déjà structuré. Une règle peut suffire ; l'interprétation d'une demande libre peut justifier une étape IA.
Peut-on choisir sur le nombre de connecteurs ? Vérifiez plutôt l'opération précise : lire un contact, l'identifier sans ambiguïté et modifier seulement les champs autorisés sont trois besoins distincts.
Initial IA peut cadrer cette intégration à partir de vos entrées, de vos outils et d'un résultat attendu. Avant de comparer les plateformes, vérifiez que vous avez choisi une première tâche suffisamment précise.
Rédaction Initial IA, 26 septembre 2026. Enrichissement le 27 septembre 2026. Sources et budget relus le 3 octobre 2026. Comparaison documentaire et protocole d'essai fourni ; aucun classement de performance ni tarif de marché estimé.
À vous de l’essayer.
Retrouvez les documents fictifs, les modèles vierges et les corrigés dans le kit pratique.
Télécharger le kit de cet article