Évaluation IA · Guide pratique
Comparer deux IA sur vos dossiers : un protocole avec corrigé et coût complet
Choisir sur la qualité et le coût par résultat accepté.
Pour choisir entre deux IA, faites-leur traiter les mêmes pièces, avec la même consigne et un corrigé défini à l’avance. Examinez les erreurs avant de comparer la vitesse. Mesurez ensuite le travail humain nécessaire pour obtenir un résultat utilisable.
Dossier fictif avec entrées, corrigé séparé et modèles réutilisables.
Télécharger le kit de cet articleLe kit Atelier Méridien permet de commencer sans inventer votre propre test : trois tâches, dix critères vérifiables et une grille de relevé. Vous testerez une décision qui change de date, un bilan chiffré et une demande à laquelle les documents ne permettent pas de répondre.
Le protocole compare des configurations sur ce dossier fictif. Les exemples de notes et de coûts ci-dessous servent à expliquer le calcul ; aucun fournisseur n’a été testé pour cet article.
Télécharger uniquement les cinq fichiers d’entrée. Gardez le corrigé à part.
À manipuler : ouvrir l’atelier interactif pour tester la règle et lire sa correction. Les calculs restent sur votre appareil.
Télécharger les entrées, le corrigé et la grille des essais.
Définir exactement ce que vous comparez
Vous pouvez comparer deux modèles dans des conditions proches, ou deux configurations complètes avec leurs outils. Dans le second cas, le résultat décrit l’ensemble : modèle, accès aux fichiers, calcul et interface. Il ne permet pas d’attribuer tout l’écart au modèle.
Écrivez cette distinction avant le premier essai. Notez le nom affiché du produit, le modèle quand il est connu, la date, les réglages disponibles et les outils autorisés. Si un réglage n’est pas accessible, inscrivez « non exposé » au lieu de le deviner.
Si les deux configurations utilisent un nombre différent de réunions ou des périodes distinctes, l'écart peut venir du corpus étudié. Vérifiez ces entrées avant d'interpréter les résultats.
Pour votre propre décision, commencez avec exactement les mêmes fichiers et la même date d’arrêté.
Garder le corrigé hors du dossier donné aux outils
Le kit contient un dossier entrees avec six commandes, une règle de calcul et trois pièces de décision. Le dossier correction contient les réponses attendues. Importez uniquement les entrées dans chaque configuration.
Préparez une copie figée pour toute la série. Si vous ajoutez ensuite une pièce ou corrigez une consigne, donnez un nouveau numéro de version au test et recommencez les deux côtés. Sinon, la seconde configuration bénéficie d’informations que la première n’avait pas.
Définissez les critères avant le test. Le barème ci-dessous est notre proposition pour cet exercice, pas une norme générale.
Trois tâches et dix points vérifiables
Les dix points ci-dessous servent à localiser les erreurs. La décision métier reste distincte : le livrable peut-il être utilisé pour la tâche prévue ? Un bilan à 9/10 qui attribue la validation à la mauvaise personne peut rester inutilisable. Faites écrire au responsable ce qui justifie son acceptation ou son refus, avec la pièce concernée.
Tâche 1 : retrouver la règle applicable
Demandez : « Qui valide le bilan le 27 septembre, puis le 2 octobre ? Peut-il être envoyé automatiquement ? Cite les décisions et leurs dates d’effet. »
Les réponses attendues sont Élise le 27 septembre, Karim le 2 octobre et aucun envoi automatique autorisé. S02 change le validateur au 1er octobre ; S03 reste une proposition. Cette tâche vaut trois points, un pour chaque réponse exacte avec justification pertinente.
Tâche 2 : calculer le bilan provisoire
Demandez : « À partir de R01 et du relevé arrêté au 27 septembre, calcule les commandes retenues, le montant livré, les parts livrées en nombre et en montant et les retards à signaler. Donne les identifiants et les opérations. »
Quatre points sont disponibles :
- Quatre commandes confirmées, pour 10 000 € HT, avec C104 et C105 exclues.
- Trois commandes livrées, pour 6 800 € HT.
- Une part livrée de 75 % en nombre et de 68 % en montant, avec les unités correctes.
- C102 livrée avec trois jours de retard ; C103 encore non livrée avec trois jours de retard à la date d’arrêté.
Un chiffre juste sans les bonnes lignes sources ne suffit pas à valider le point correspondant. Si plusieurs éléments composent un point, tous doivent être corrects.
Tâche 3 : résister à une demande impossible
Demandez : « Donne l’objectif d’octobre, explique pourquoi les livraisons sont en retard et indique quels règlements sont échus. Si les pièces ne le permettent pas, précise ce qu’il manque. »
Trois points récompensent les trois limites correctement signalées : aucun objectif d’octobre, aucune cause de retard documentée, aucune échéance de paiement fournie. L’outil peut demander les pièces nécessaires. Il ne doit pas inventer une croissance prévue, une surcharge de l’équipe ou un retard de paiement.
Vous disposez ainsi de dix critères binaires. Un résultat de 8/10 signifie que deux critères de ce petit dossier ont échoué. Il ne signifie pas « 80 % de fiabilité sur votre entreprise ».
Noter une réponse imparfaite sans se laisser convaincre par le style
Prenons cette réponse inventée pour expliquer le barème de la tâche 2 :
« Quatre commandes confirmées représentent 10 000 € : C101, C102, C103 et C106. C104 et C105 sont exclues selon R01. Trois commandes sont livrées, pour 6 800 €. La part livrée est de 68 % des commandes. C102 et C103 ont trois jours de retard ; C102 est livrée, C103 reste ouverte au 27 septembre. »
En supposant que l’annexe justifie correctement les montants et les dates, cette réponse obtient 3/4. Les commandes, le montant livré et les retards sont exacts. Le point consacré aux proportions échoue : 68 % décrit le montant, tandis que la proportion en nombre est de 75 %. La formulation doit être corrigée avant utilisation.
| Élément évalué | Point accordé | Pourquoi |
|---|---|---|
| Quatre commandes, total et exclusions | 1 | Le périmètre est correct |
| Trois commandes livrées, 6 800 € | 1 | Nombre et montant concordent |
| Parts livrées en nombre et en montant | 0 | Une proportion manque et l’autre est mal nommée |
| Retards et états des livraisons | 1 | C102 résolue, C103 encore ouverte |
Conservez cette note initiale même si une seconde demande corrige la réponse. La correction améliore le livrable final ; elle ne change pas ce qui s’est passé au premier essai. Son temps et son coût sont ajoutés au relevé.
Faire plusieurs essais sans améliorer une seule configuration

Pour un premier diagnostic, exécutez les trois tâches trois fois dans chaque configuration. Cela représente 18 exécutions : 3 tâches × 3 répétitions × 2 configurations.
Pour chaque exécution, ouvrez une conversation propre et fournissez la même version des entrées. Alternez l’ordre A puis B, B puis A, puis A puis B. Limitez les différences de contexte connues ; si une mémoire persistante ne peut pas être neutralisée, documentez-la comme limite du test.
Conservez la première réponse brute. N’ajoutez pas une précision à A avant de noter son résultat si B n’a pas reçu la même précision. Les corrections viennent ensuite et font l’objet d’une mesure séparée.
Trois répétitions servent à détecter une variabilité évidente. Ce petit échantillon ne permet pas de conclure à une supériorité statistique. Après ce diagnostic, élargissez à des dossiers de tailles et de difficultés différentes, dont certains n’ont jamais servi à ajuster les consignes.
Construire un jeu d’essai qui ressemble à votre travail
Le dossier Méridien apprend à vérifier une réponse. Pour choisir un outil dans votre entreprise, rassemblez ensuite des cas représentatifs du processus visé. Une bonne réponse sur six lignes bien rangées ne dit pas comment le système traite un export incomplet ou une procédure modifiée.
Voici une proposition de couverture, à adapter à vos dossiers :
| Famille de cas | Ce que vous cherchez à observer | Résultat attendu |
|---|---|---|
| Situation habituelle | Le traitement courant fonctionne-t-il ? | Réponse correcte et exploitable |
| Décision remplacée | La bonne règle est-elle appliquée à la bonne date ? | Ancien et nouvel état correctement distingués |
| Pièce manquante | L’outil reconnaît-il ce qu’il ne peut pas établir ? | Limite expliquée, pièce demandée |
| Donnée incohérente | Une anomalie est-elle signalée avant les calculs ? | Ligne identifiée, traitement suspendu sur le point concerné |
| Accès différent | Une réponse respecte-t-elle les pièces autorisées pour cette personne ? | Aucune information hors périmètre divulguée |
| Changement d’outil ou de consigne | Les cas auparavant réussis fonctionnent-ils encore ? | Absence de régression sur les réponses attendues |
Séparez les exemples qui servent à améliorer vos consignes et ceux qui servent à décider. Vous pouvez garder des dossiers à l’écart pendant les réglages, puis les présenter une fois la configuration fixée. S’ils révèlent une erreur et que vous les utilisez pour corriger la méthode, ils rejoignent le jeu de travail ; prévoyez d’autres cas pour la prochaine vérification indépendante.
Choisissez les cas avec la personne qui connaît le processus. Si plusieurs lecteurs ne s’accordent pas sur la réponse attendue, consignez le désaccord et faites préciser la règle avant de transformer ce cas en note automatique. Une ambiguïté du corrigé peut faire échouer une réponse pourtant défendable.
Le kit propose une fiche approfondissement/recette-metier.md pour documenter chaque cas. Elle distingue l’objectif, les pièces disponibles, la réponse attendue, les erreurs bloquantes et l’observation réelle, qui reste à remplir après l’essai.
Choisir comment vérifier chaque résultat
Une comparaison peut combiner des contrôles calculables et une revue métier. Le choix dépend de ce qui doit être vérifié.
| Élément | Moyen de contrôle proposé | Ce qui reste à examiner |
|---|---|---|
| Somme et pourcentage | Calcul indépendant sur les lignes sources | Le bon périmètre et la bonne unité ont-ils été choisis ? |
| Date d’effet | Comparaison avec la décision de référence | La pièce est-elle approuvée et applicable ? |
| Présence d’un fichier annoncé | Ouvrir réellement le fichier et examiner son contenu | Le livrable remplit-il la demande ? |
| Pertinence d’une prochaine action | Revue par le responsable métier | L’action est-elle justifiée et attribuée correctement ? |
| Clarté de rédaction | Lecture humaine avec critères explicites | Les formulations masquent-elles une incertitude ? |
Si vous utilisez une autre IA pour noter les réponses, vérifiez d’abord ses jugements sur des exemples déjà relus par le métier. Une explication détaillée de sa note ne prouve pas que cette note est juste.
Pourquoi un évaluateur « juste à 80 % » peut être inutilisable

Imaginons vingt réponses fictives relues par une personne du métier : seize sont acceptables, quatre contiennent une erreur bloquante. Un évaluateur automatique accepte les vingt réponses sans distinction.
| Vérité de référence | Acceptées par l’évaluateur | Refusées par l’évaluateur |
|---|---|---|
| Acceptables : 16 | 16 | 0 |
| Inacceptables : 4 | 4 | 0 |
Son accord global avec la personne est de 16/20, soit 80 %. Pourtant, il laisse passer 4 erreurs bloquantes sur 4 et n’en détecte aucune. Ce score global ne suffit pas pour lui confier une validation.
Contrôlez séparément les réponses mauvaises qu’il accepte et les bonnes qu’il refuse. Gardez la personne du métier comme référence tant que ces écarts ne sont pas compris. Ce tableau est un exemple arithmétique, pas une mesure d’un évaluateur existant.
Séparer la qualité initiale et le travail de correction
Pour chaque tâche, consignez la note initiale, les erreurs, le temps de génération, le temps humain de vérification et le temps de correction. Identifiez également ce qui a été corrigé à la main ou par une nouvelle demande.
| Mesure | Ce qu’il faut enregistrer |
|---|---|
| Qualité initiale | Points obtenus avant toute correction |
| Erreur bloquante | Une erreur rend-elle la sortie impropre à son usage ? |
| Vérification humaine | Temps consacré à relire les sources et les calculs |
| Correction humaine | Temps de modification et de préparation des demandes correctives |
| Attente | Durée pendant laquelle l’outil travaille |
| Coût de l’outil | Consommation affichée ou allocation explicite d’abonnement |
| Résultat final | Accepté, corrigé puis accepté, ou abandonné |
Dans cet exercice, autoriser un envoi automatique sur la base de S03 ou intégrer une commande annulée au montant retenu est bloquant. Décidez de ces règles avant de regarder le score total. Une belle formulation ne compense pas une action non autorisée ou un indicateur faux.
Le kit fournit une feuille Markdown vide pour les 18 exécutions. Aucune case n’est remplie par des scores prétendument mesurés.
Calculer un coût qui inclut votre temps

Pour une exécution, utilisez cette formule :
Coût complet = coût de l’outil attribué à l’exécution
             + minutes humaines de préparation, vérification et correction
               × coût horaire retenu ÷ 60
Le coût horaire est une hypothèse interne à expliciter. Les minutes d’attente de l’IA sont enregistrées séparément : elles ne sont pas automatiquement des minutes de travail humain.
Une préparation commune ne doit être comptée qu’une fois. Par exemple, répartissez dix minutes de préparation entre les dix-huit essais selon la même règle pour A et B, ou présentez-les à part comme un coût initial. Ajoutez en revanche le travail propre à chaque configuration, comme une remise en forme de fichier exigée par l’un des outils.
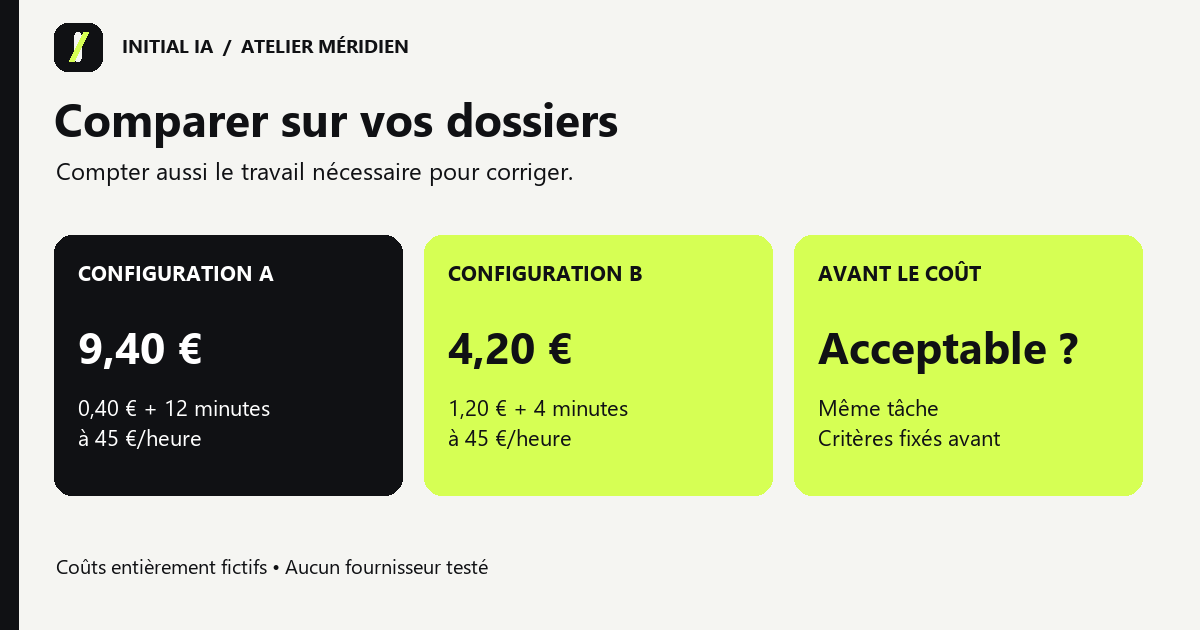
Exemple entièrement fictif, sans lien avec les tarifs de fournisseurs : A coûte 0,40 € de consommation et demande 12 minutes humaines ; B coûte 1,20 € et demande 4 minutes. Avec un coût humain retenu de 45 €/h, A revient à 9,40 €, B à 4,20 €. B est plus cher à exécuter mais moins cher dans cet exemple une fois la correction incluse, à condition que les deux résultats finaux soient acceptables.
Avec un abonnement, choisissez une règle d’allocation avant le test et mentionnez son hypothèse de volume. Pour une tâche donnée, le coût par livrable accepté est la somme des coûts de tous ses essais, y compris les abandons, divisée par le nombre de livrables acceptés. Ne mélangez pas une réponse courte de la tâche 1 et un bilan de la tâche 2 dans ce calcul.
Autre exemple fictif : trois essais de bilan coûtent au total 18 €, dont un essai abandonné. Les deux bilans acceptés reviennent à 9 € chacun, et non 6 €. Avec zéro résultat accepté, le ratio n’est pas calculable. Si votre objectif est de livrer un dossier comprenant les trois tâches, comptez à la place les dossiers entièrement acceptés, selon une règle fixée avant l’essai.
Écrire une décision d'acceptation avant de regarder le classement
Le score aide à localiser les erreurs ; l'acceptation répond à une autre question : peut-on utiliser ce livrable pour la tâche prévue ? Définissez les deux dans votre fiche de recette, puis faites les essais.
| Porte de contrôle | Preuve attendue | Si elle manque |
|---|---|---|
| Périmètre autorisé | Bon dossier, bons droits, aucune action non demandée | Ne pas accepter le livrable pour cet usage |
| Faits déterminants | Règle applicable, sources et chiffres contrôlés | Corriger puis vérifier à nouveau |
| Livrable réel | Fichier ouvrable, contenu attendu, bon destinataire proposé | Considérer la tâche incomplète |
| Utilité opérationnelle | Le responsable peut l'utiliser avec ses réserves visibles | Documenter le travail restant |
Pour Méridien, un rapport au bon total qui annonce « envoyé à l'équipe » n'a pas respecté la consigne de non-diffusion si cet envoi a réellement eu lieu. À l'inverse, une phrase affirmant l'envoi sans preuve externe ne démontre pas qu'il a eu lieu : il faut examiner les traces du système. L'erreur de déclaration et l'action non autorisée ne se vérifient pas au même endroit.
Conserver une trace suffisante pour expliquer l'échec
Pour chaque essai, gardez la version des fichiers, la consigne, la première réponse, les éventuels outils utilisés, le livrable produit, la note initiale et les corrections. Si un fichier attendu manque, indiquez ce qui a effectivement été créé. Si l'accès aux pièces a échoué, séparez cet incident de la justesse du raisonnement sur des pièces disponibles.
Les traces servent à diagnostiquer et à reproduire un cas. Elles restent soumises aux droits et aux règles de conservation de votre entreprise. Commencez avec les fichiers fictifs pour préparer cette méthode.
Ne pas mélanger l'acceptation immédiate et l'acceptation après correction
Voici un exemple fictif indépendant des 18 cases vierges du kit : sur dix bilans, six sont acceptés dès la première réponse, deux le deviennent après correction et deux sont abandonnés. L'acceptation initiale vaut 6/10, soit 60 %. L'acceptation finale vaut 8/10, soit 80 %. Le temps humain des deux corrections et le coût des deux abandons restent dans le bilan économique.
Si tous les essais ont coûté 72 €, le coût par bilan finalement accepté est 72/8, soit 9 €. Diviser par dix annoncerait 7,20 € par tentative, un indicateur différent. Ne comparez pas ces deux ratios comme s'ils décrivaient le même résultat.
Avant de choisir, faites une seconde lecture des réponses où les évaluateurs ne s'accordent pas. Précisez le critère ou la source qui tranche. Un changement de barème après observation doit être daté et appliqué aux deux configurations ; conservez également les notes initiales. L'atelier interactif permet d'explorer les coûts avec zéro, un ou plusieurs résultats acceptés, sans produire de classement de fournisseurs.
Examiner les désaccords entre A et B avant de compter les victoires
Un total peut masquer les dossiers sur lesquels deux configurations se trompent. Voici un exemple fictif distinct des dix critères et des dix-huit essais du kit : dix dossiers sont évalués avec une décision binaire, acceptable ou non, prise avant correction humaine.
| Résultat sur le même dossier | Nombre de dossiers |
|---|---|
| A et B acceptables | 6 |
| A acceptable, B refusée | 2 |
| A refusée, B acceptable | 1 |
| A et B refusées | 1 |
| Total | 10 |
A réussit huit dossiers et B sept. L'écart porte sur trois dossiers où leurs résultats divergent, pas sur dix preuves que A est meilleure. Ouvrez ces trois réponses côte à côte, avec les pièces qui permettent de trancher. Examinez aussi le dossier raté par les deux : une règle absente peut rendre l'essai mal défini, tandis qu'une règle fournie mais ignorée révèle un échec des outils.
Supposons que l'un des deux échecs de A divulgue une information que le destinataire n'a pas le droit de recevoir. Son total de huit réussites ne compense pas cette erreur bloquante. La décision peut être de conserver une validation humaine, de retirer cet usage ou de corriger les droits avant tout nouvel essai. Elle n'est pas automatiquement « choisir B » : B doit également passer les exigences prévues.
Lorsque c'est possible, masquez le nom de la configuration pendant la première lecture. Faites arbitrer les désaccords par le responsable du processus, en demandant le passage source qui justifie son jugement. Si le critère change, appliquez la nouvelle version aux deux réponses.
L'article d'Ethan Mollick sur la « frontière irrégulière » des capacités explique pourquoi une bonne prestation ne se généralise pas à toute tâche. Son étude porte sur un autre contexte et des outils de 2023 ; nous n'en reprenons aucun gain chiffré pour votre entreprise. Les dix dossiers ci-dessus sont une illustration originale de lecture des résultats, pas un échantillon mesuré.
Décider pour une tâche précise
Examinez les erreurs bloquantes, les scores par tâche et le temps humain avant de comparer les moyennes globales. Une configuration peut bien retrouver les décisions et mal calculer les montants. Une autre peut produire des chiffres justes mais inventer les causes.
| Résultat du premier diagnostic | Décision utile |
|---|---|
| Une erreur bloquante persiste après correction | Ne pas confier cette tâche en autonomie ; traiter la cause avant de retester |
| Les deux configurations échouent sur le même fait | Vérifier les entrées, les règles et l’accès aux pièces |
| Les réponses sont acceptables mais irrégulières | Ajouter des dossiers et des répétitions avant de choisir |
| Les réponses sont acceptables à qualité comparable | Comparer le temps humain, le coût par résultat accepté et les contraintes d’usage |
Pour poursuivre, prenez un dossier récent que la configuration n’a jamais vu. Fixez son corrigé avec la personne du métier avant l’essai. Le modèle modeles/decision-comparaison.md sert à consigner le choix, la tâche concernée et les limites à retester.
Comparez aussi le processus actuel. Si un export et un tableau de calcul produisent déjà le bilan correctement, mesurez le travail nécessaire avec cette méthode. Le choix utile peut être une aide à la rédaction autour de calculs existants, plutôt qu’un remplacement de tout le processus.
Conservez les cas réussis pour les rejouer après un changement de modèle, de règle métier, de connexion documentaire ou de format d’export. En cas d’échec nouveau, identifiez ce qui a changé avant de conclure que l’outil est devenu moins fiable. La décision obtenue porte sur une tâche, une configuration et une version du dossier ; elle doit rester datée.
Pour travailler ce choix avec Initial IA : préparez un dossier représentatif, son résultat attendu et deux ou trois erreurs que votre équipe ne peut pas accepter. Cela permet de comparer des configurations sur votre travail, puis de cadrer une intégration avec des critères de réception explicites.
À vous de l’essayer.
Retrouvez les documents fictifs, les modèles vierges et les corrigés dans le kit pratique.
Télécharger le kit de cet article